Industrie 4.0 : 8 leviers concrets pour gagner en productivité
28 septembre 2026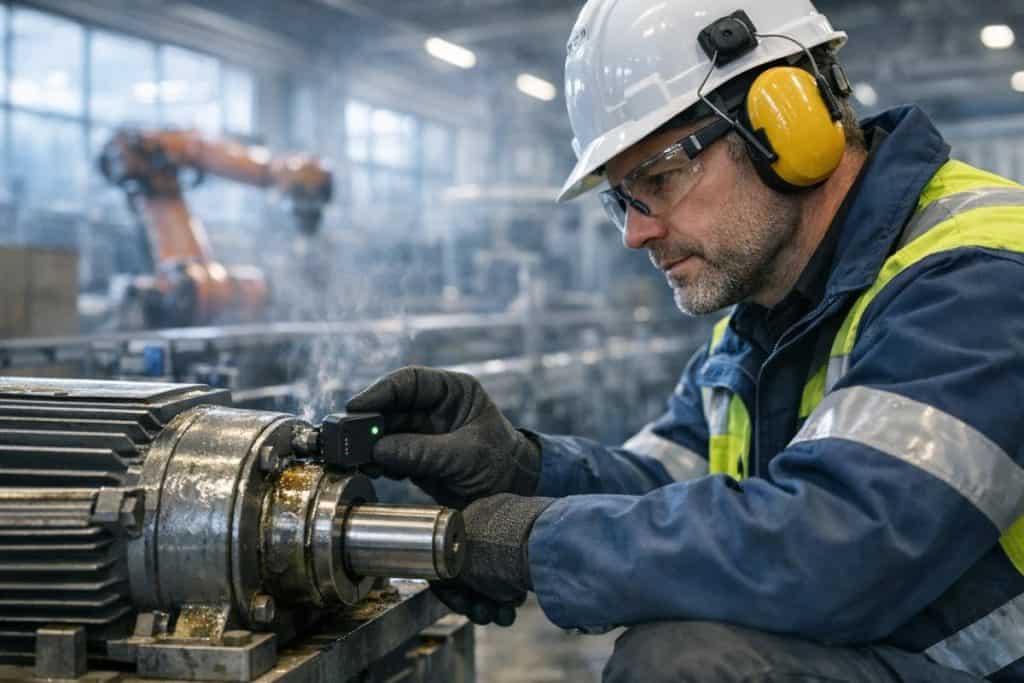
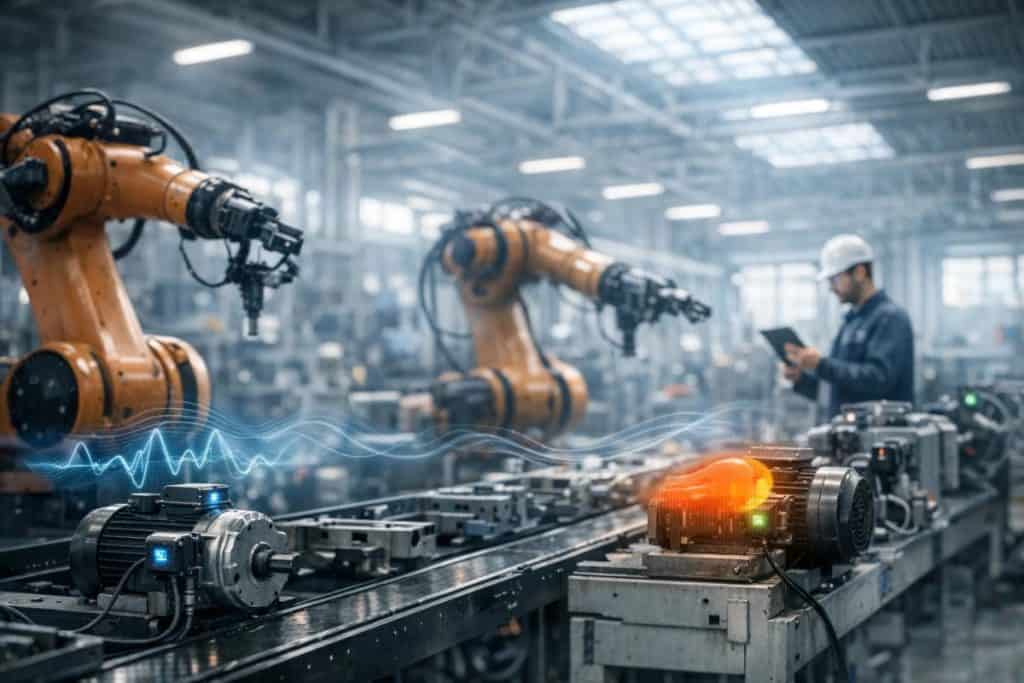
Un arrêt machine non planifié peut coûter plusieurs milliers d’euros par heure dans l’industrie, parfois bien davantage lorsque la production se bloque en cascade. Et il suffit souvent d’un roulement qui chauffe, d’une vibration qui dérive ou d’un moteur qui consomme anormalement pour faire basculer une ligne entière dans l’imprévu.
La maintenance prédictive s’attaque précisément à ce scénario : utiliser la donnée pour détecter les signaux faibles avant la panne, planifier l’intervention au bon moment et réduire les immobilisations. Mais pour transformer des capteurs en décisions, il faut une méthode — et une organisation.
Passer du “on répare quand ça casse” à l’intervention au bon moment
La logique traditionnelle de maintenance corrective est simple : on intervient après la panne. Problème : elle maximise l’aléa. À l’inverse, la maintenance préventive programme des interventions à échéances fixes (heures de fonctionnement, calendrier). Elle réduit le risque, mais peut conduire à remplacer trop tôt des pièces encore en bon état.
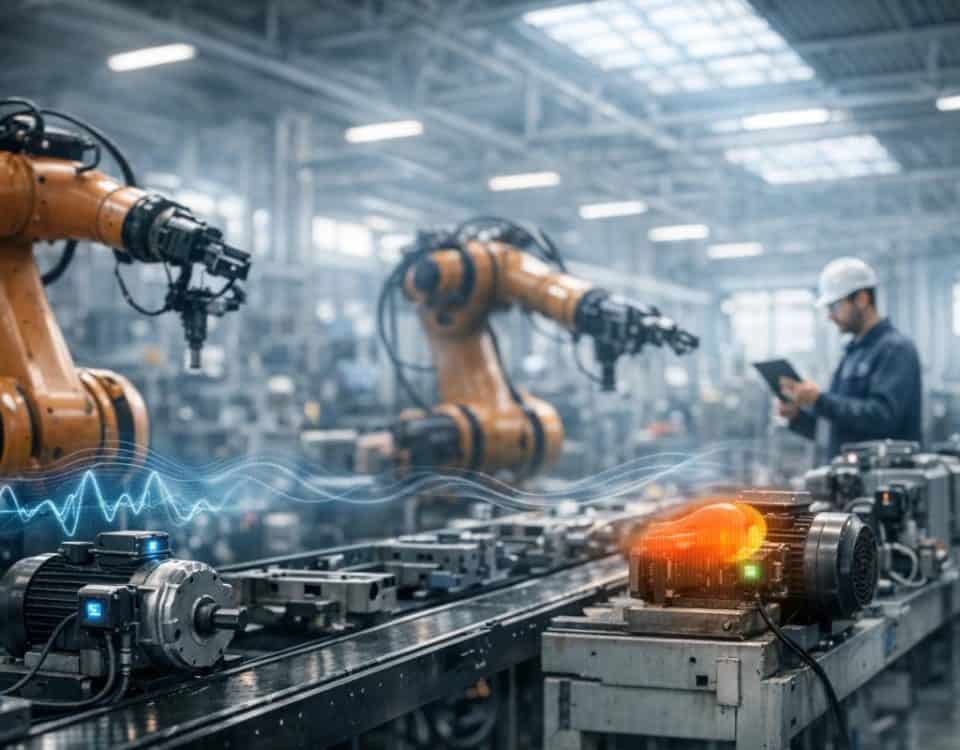
La maintenance prédictive vise un compromis plus fin : intervenir quand les indicateurs montrent une dégradation réelle, ni trop tôt, ni trop tard. Elle s’appuie sur des capteurs, des historiques d’interventions et de production, et une analyse de données capable de relier des symptômes (température, vibrations, intensité électrique, pression, bruit) à des modes de défaillance.
Ce que change la maintenance prédictive sur le terrain
- Moins d’arrêt machine subi : on anticipe la panne et on planifie une fenêtre d’intervention.
- Des interventions plus ciblées : on remplace la pièce fautive plutôt que d’immobiliser plus largement.
- Une meilleure disponibilité : la maintenance devient un levier de performance, pas un centre de coût isolé.
Les capteurs, base de la prédiction : quoi mesurer, où et à quel rythme
Sans mesure, pas de prédiction. Le choix des capteurs conditionne la qualité des signaux et, donc, la capacité à éviter un arrêt machine. La bonne approche consiste à partir des équipements critiques et des pannes les plus coûteuses : un compresseur qui alimente une ligne complète, un moteur de convoyeur, une pompe sur un process continu, une broche de machine-outil.
Les capteurs les plus utilisés en maintenance prédictive
- Vibrations : indispensables pour détecter déséquilibre, désalignement, défaut de roulement, jeu mécanique.
- Température : utile pour repérer échauffements anormaux (moteurs, roulements, armoires électriques).
- Courant et tension : l’analyse électrique révèle surcharge, frottements, dérives de consommation.
- Pression et débit : cruciaux pour pompes, circuits pneumatiques/hydrauliques, filtration encrassée.
- Acoustique/ultrasons : efficace pour fuites d’air comprimé, décharges partielles, défauts précoces.
La question décisive : fréquence d’échantillonnage et contexte
Mesurer “un peu” ne suffit pas toujours. Une vibration utile sur un roulement peut nécessiter un échantillonnage plus élevé qu’une température de palier, plus lente à évoluer. À l’inverse, multiplier les mesures sans stratégie noie les équipes sous des alertes. La clé est d’associer la mesure au mode de défaillance visé : un défaut qui apparaît en quelques minutes n’a pas la même signature qu’une dérive sur plusieurs semaines.
Autre point souvent négligé : le contexte opérationnel. Une hausse de vibration n’a pas le même sens à pleine charge qu’au ralenti. Pour éviter les faux positifs, il faut corréler les capteurs avec des données de production (cadence, recette, lots, changements d’outils) et des événements machine (démarrages, arrêts, nettoyages, cycles).
Analyse de données : transformer des signaux bruts en alertes actionnables
La promesse de la maintenance prédictive ne tient pas à l’accumulation de courbes, mais à la capacité à décider. L’analyse de données sert à détecter une anomalie, estimer une tendance, qualifier un risque et prioriser une action. Dans les faits, trois niveaux coexistent souvent sur un même site, selon la maturité et la criticité des actifs.
1) Seuils et règles : simple, rapide, parfois suffisant
On définit des seuils (température maximale, niveau de vibration) et des règles (si dérive sur 7 jours, déclencher une inspection). C’est efficace pour démarrer, surtout si l’expertise métier est forte. Limite : ces règles peuvent générer des alertes inutiles si la variabilité normale est mal comprise.
2) Détection d’anomalies : repérer le “pas normal” sans modèle de panne parfait
Quand les pannes sont rares (bonne nouvelle) et les historiques incomplets (réalité fréquente), la détection d’anomalies est un bon compromis. L’idée : apprendre ce qu’est un fonctionnement normal, puis signaler les écarts significatifs. Cela marche bien pour des équipements stables, et permet d’anticiper sans attendre d’avoir des dizaines d’exemples de pannes.
3) Modèles prédictifs : estimer un risque et une échéance
Le niveau le plus ambitieux consiste à prédire la probabilité de défaillance ou une durée de vie restante. Utile, mais exigeant : données propres, traçabilité des interventions, labels de pannes fiables, et parfois une instrumentation plus fine. Dans l’industrie, l’objectif n’est pas de “faire de l’IA” à tout prix : c’est de réduire les arrêts machine et de sécuriser la production. Un modèle moins sophistiqué mais bien intégré vaut souvent mieux qu’un algorithme brillant mais inexploité.
Ce qui rend une alerte réellement exploitable
- Une cause probable (ex. désalignement, roulement, cavitation) plutôt qu’un simple “anomalie”.
- Un niveau de criticité : impact potentiel sur sécurité, qualité, continuité.
- Une recommandation : contrôle, graissage, resserrage, planification d’arrêt.
- Un historique : évolution de la mesure, comparaisons avant/après intervention.
GMAO et processus : la prédiction ne sert à rien si elle ne déclenche pas une action
La plupart des projets échouent non pas sur la partie capteurs, mais sur l’exécution. Une alerte qui reste dans un tableau de bord ne réduit aucun arrêt machine. C’est ici que la GMAO devient centrale : elle traduit un signal en ordre de travail, assigne une responsabilité, trace l’intervention et enrichit l’historique.
Connecter la maintenance prédictive à la GMAO
Quand une alerte est qualifiée, elle doit pouvoir générer automatiquement ou semi-automatiquement une demande d’intervention dans la GMAO, avec l’équipement concerné, la description, la criticité, et les pièces potentiellement nécessaires. L’objectif : éviter le “copier-coller” et la perte d’information entre l’équipe data, l’automatisme et les techniciens.
- Standardiser les codes pannes pour relier symptômes, causes et actions.
- Tracer les temps (diagnostic, intervention, attente pièces) pour mesurer le gain réel.
- Capitaliser : après intervention, enregistrer ce qui a été constaté pour améliorer les modèles.
Organiser la réponse : qui fait quoi, et sous quels délais
Une maintenance prédictive efficace s’appuie sur des règles de gestion : qui reçoit l’alerte, qui la valide, sous combien d’heures, et avec quel plan d’escalade si le risque augmente. Dans un site multi-lignes, la priorisation est essentielle : toutes les anomalies ne se valent pas. L’approche la plus pragmatique consiste à classer les équipements par criticité (sécurité, goulot de production, coût d’arrêt) et à calibrer les seuils d’alerte en conséquence.
Déployer sans se tromper : démarrer petit, viser le ROI, industrialiser
La tentation est forte de “capteuriser” l’usine entière. C’est souvent un piège budgétaire et organisationnel. Une stratégie efficace démarre par quelques actifs à fort impact, avec un objectif clair : réduire les arrêts machine non planifiés, raccourcir le diagnostic et stabiliser la production.
Choisir les bons cas d’usage
- Actifs critiques : une panne arrête une ligne ou dégrade la qualité.
- Pannes récurrentes : roulements, défauts d’alignement, surchauffes, encrassements.
- Équipements instrumentables : accès possible, mesure fiable, conditions stables.
Les indicateurs qui parlent à la direction comme au terrain
- MTBF (temps moyen entre pannes) : doit augmenter sur les actifs ciblés.
- MTTR (temps moyen de réparation) : doit baisser grâce à un diagnostic plus rapide.
- Taux d’arrêt machine non planifié : l’indicateur roi pour juger l’efficacité.
- Coût de maintenance : attention, il peut d’abord augmenter si l’on rattrape un passif.
Trois écueils fréquents à éviter
- La donnée sale : capteurs mal calibrés, horodatages incohérents, unités mélangées. Sans gouvernance, l’analyse de données devient fragile.
- Les faux positifs : trop d’alertes tuent l’alerte. Il faut ajuster les règles, tenir compte des régimes de fonctionnement, et donner un retour terrain.
- L’absence de boucle d’amélioration : sans retour dans la GMAO sur la cause réelle, on ne progresse pas. La prédiction doit apprendre.
À maturité, la maintenance prédictive n’est plus un projet “data” à côté de l’usine : c’est une manière de piloter la fiabilité, au même titre que la qualité ou la productivité. Les capteurs captent les signaux, l’analyse de données transforme ces signaux en décisions, et la GMAO ancre ces décisions dans des ordres de travail traçables. C’est cette chaîne complète — du terrain à l’action — qui fait la différence le jour où la machine, au lieu de s’arrêter net, vous laisse le temps d’intervenir avant la panne.