Industrie 4.0 : 7 étapes pour digitaliser une usine sans chaos
29 septembre 2026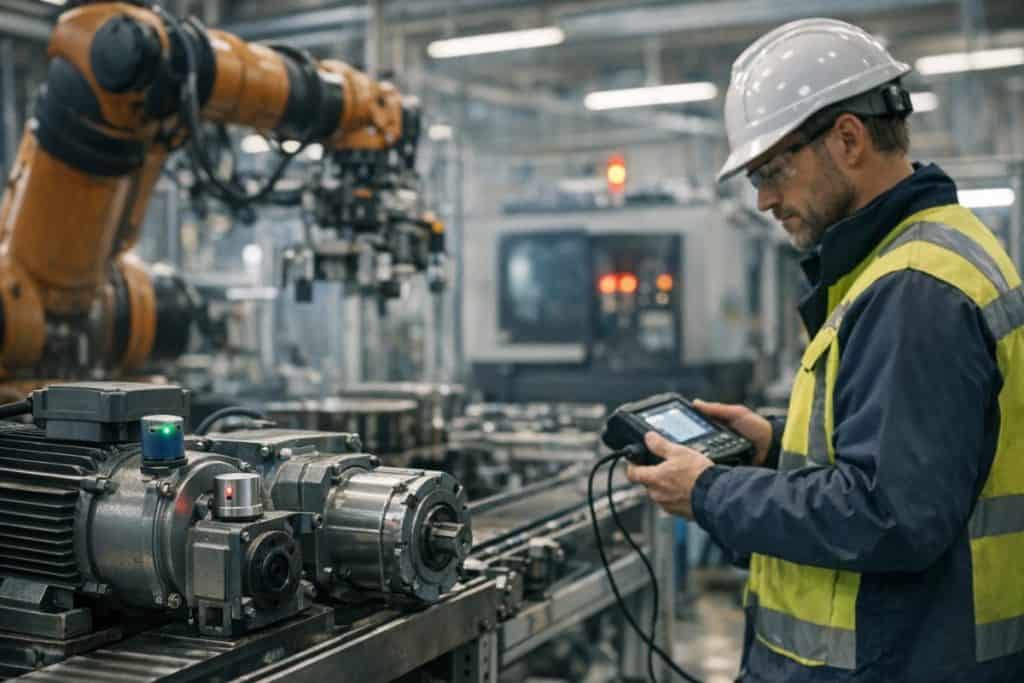
Une heure d’arrêt machine sur une ligne critique peut coûter des dizaines de milliers d’euros entre la production perdue, les rebuts et les pénalités de livraison. Et dans beaucoup d’usines, ces arrêts surviennent encore « sans prévenir », malgré des plans de maintenance bien huilés.
La promesse de la maintenance prédictive est simple : transformer les signaux faibles (vibrations, température, intensité, pression) en alertes actionnables, avant la panne. Grâce aux capteurs industriels et à l’analyse de données, la maintenance cesse d’être une course contre la montre pour devenir un pilotage de la fiabilité à partir de faits mesurés.
Pourquoi la maintenance planifiée ne suffit plus face aux arrêts non programmés
La maintenance préventive « calendrier » a longtemps été la norme : on remplace une pièce toutes les X heures, on graisse toutes les Y semaines, on contrôle tous les Z mois. Cette logique reste utile, mais elle atteint vite ses limites lorsque les modes de défaillance varient selon la charge, la qualité matière, l’environnement ou les réglages.
Un roulement peut tenir 18 mois dans un atelier tempéré et 6 mois dans un environnement poussiéreux. Une pompe peut vieillir prématurément si la cavitation s’installe, sans que le planning de maintenance ne le voie venir. Résultat : soit on sur-maintient (coût, immobilisations, risque d’erreur humaine), soit on subit des pannes qui n’étaient pas au programme.
Trois angles morts typiques des plans “au temps”
- Variabilité d’usage : cycles, charges et vitesses changent d’une série à l’autre, donc l’usure réelle n’est pas proportionnelle au temps.
- Défauts progressifs : désalignement, déséquilibre, encrassement, défaut de lubrification s’installent lentement et se lisent mieux sur des tendances que sur une inspection ponctuelle.
- Effets en chaîne : une micro-dérive sur un poste (vibration, température) finit par dégrader le poste suivant, et l’arrêt machine surgit là où on ne l’attend pas.
La maintenance prédictive ne remplace pas tout : elle complète la préventive et la corrective en ciblant précisément les interventions, au moment où elles créent le plus de valeur — avant la casse, mais sans intervenir trop tôt.
Capteurs industriels : quels signaux surveiller pour détecter une panne avant qu’elle n’arrive
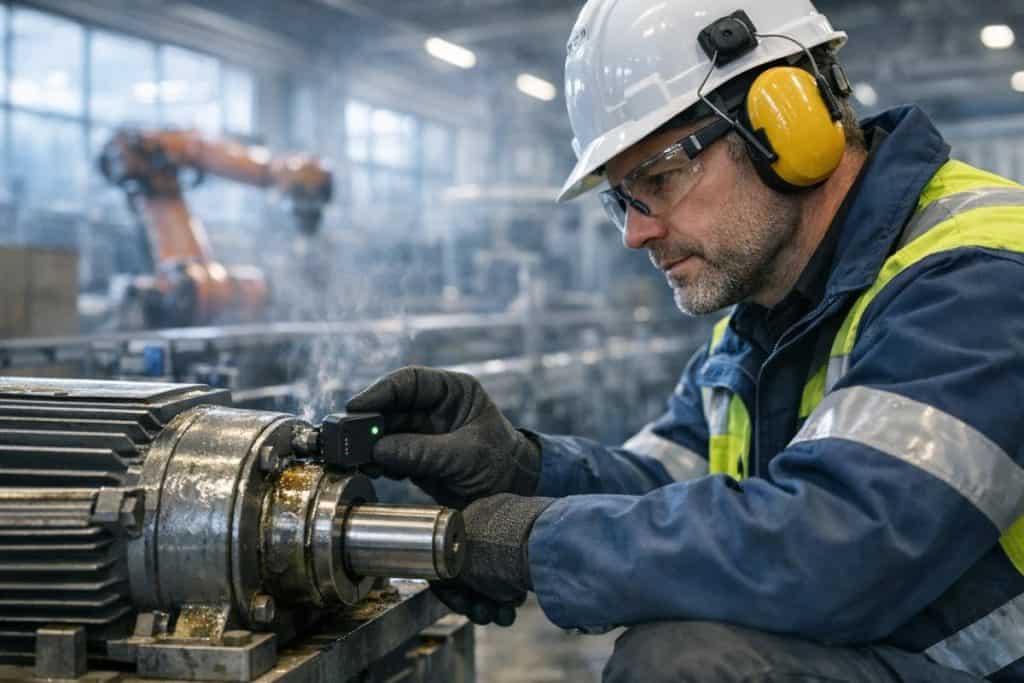
Le cœur du dispositif tient en un mot : mesure. Les capteurs industriels rendent visibles des phénomènes que l’œil et l’oreille ne perçoivent pas, ou trop tard. Le choix des signaux dépend des actifs, mais quelques familles reviennent dans la plupart des projets.
Les mesures les plus rentables sur les équipements tournants
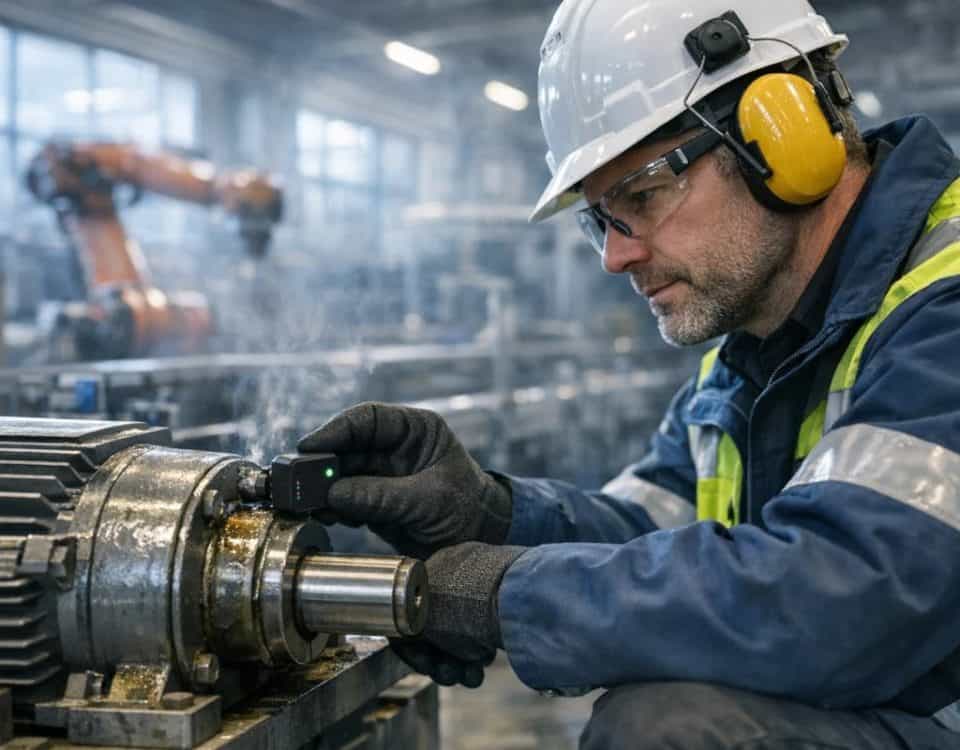
- Vibrations : essentielles pour les moteurs, réducteurs, ventilateurs, broches. Elles révèlent déséquilibre, désalignement, défaut de roulement, jeu mécanique.
- Température : sur paliers, armoires électriques, lubrification. Une dérive lente est souvent un indicateur précoce.
- Courant et puissance : une signature électrique peut traduire un effort anormal, un frottement, un problème de charge ou une dégradation du rendement.
- Acoustique / ultrasons : utile pour fuites d’air comprimé, cavitation, défauts de lubrification naissants.
Process et utilités : pression, débit, qualité d’énergie
- Pression / débit : détectent encrassement de filtres, dérive de pompe, fuite, vanne qui se grippe.
- Qualité d’air et humidité : facteurs aggravants sur certains process (poudres, électroniques, corrosion).
- Qualité réseau : micro-coupures, harmoniques, surtensions qui accélèrent l’usure de variateurs et moteurs.
Point clé : on ne « capte » pas tout. On instrumente les actifs qui font mal quand ils tombent (goulots, équipements à délai d’approvisionnement long, machines critiques sécurité/qualité), puis on élargit. Une stratégie par paliers évite de disperser le budget et permet de démontrer rapidement un gain sur l’arrêt machine.
Analyse de données : du bruit de capteurs aux alertes exploitables en atelier
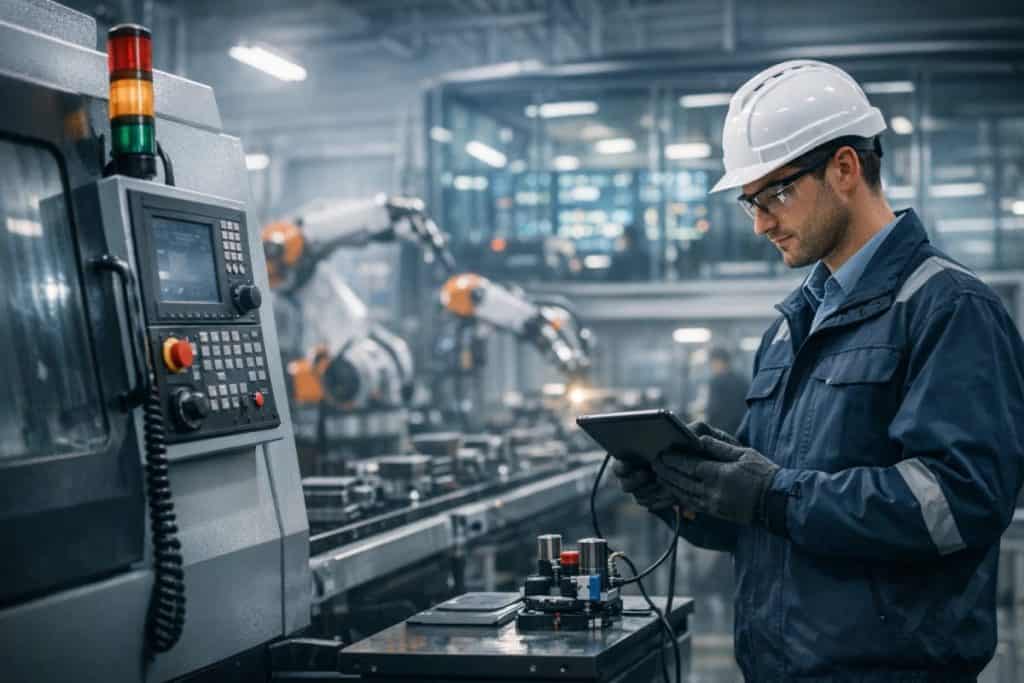
Collecter des données n’a de valeur que si elles se transforment en décisions. L’analyse de données en maintenance prédictive suit généralement une chaîne simple : acquisition, nettoyage, contextualisation, détection d’anomalies, puis recommandation d’action. Chaque étape compte, car l’industrie produit rarement des données « propres » par défaut.
Nettoyer et contextualiser : la base souvent sous-estimée
Une vibration brute n’a pas le même sens à 20% de charge ou à 95%. Une température d’huile varie selon la saison et la cadence. Sans contexte (état machine, recette, vitesse, lot matière), le risque est de générer des alarmes inutiles — et de perdre la confiance du terrain.
- Synchronisation des horodatages entre capteurs, PLC, SCADA et CMMS.
- Filtrage des valeurs aberrantes (capteur débranché, saturation, pertes réseau).
- Segmentation par режим (démarrage, stabilisé, arrêt, nettoyage) pour comparer ce qui est comparable.
Détection d’anomalies ou modèles prédictifs : deux approches complémentaires
Dans la pratique, beaucoup de sites démarrent avec des méthodes robustes : seuils dynamiques, tendances, règles expertes, détection d’anomalies. Elles donnent vite des résultats et s’expliquent facilement. Les modèles plus avancés (apprentissage automatique) deviennent pertinents quand le parc est instrumenté, que l’historique est suffisant, et que les pannes rares doivent être anticipées plus tôt.
- Anomalies : on repère une dérive par rapport au comportement normal, sans forcément « nommer » la panne.
- Prédiction : on estime une probabilité de défaillance ou un temps restant avant panne, si les données et les retours de maintenance le permettent.
Le dernier mètre : transformer l’alerte en intervention
Une alerte utile répond à trois questions : « Quoi ? », « Où ? », « Quand ? ». Elle indique l’équipement, l’indicateur en dérive, la gravité, et propose une action (inspection, lubrification, alignement, remplacement). Sans cela, la maintenance prédictive se réduit à un tableau de bord de plus.
Les organisations les plus efficaces relient l’alerte au système de GMAO : création de ticket, priorisation, préparation pièces/outillage, et retour d’expérience après intervention. Ce bouclage est crucial pour améliorer la fiabilité et affiner les modèles.
Déployer une maintenance prédictive qui réduit vraiment les arrêts machine : méthode et pièges à éviter
Le succès dépend moins du “niveau d’IA” que de la méthode. Une usine peut obtenir des gains significatifs avec une instrumentation ciblée et des analyses pragmatiques, à condition de choisir le bon périmètre et de sécuriser l’adoption terrain.
Commencer par les actifs critiques et un objectif mesurable
Un projet solide démarre par un cas d’usage : réduire les arrêts sur une presse, sécuriser un convoyeur goulot, fiabiliser une ligne de conditionnement, éviter les pannes de compresseur. L’objectif se chiffre : baisse du nombre d’arrêts machine non planifiés, réduction du MTTR, amélioration du TRS, diminution des rebuts liés aux dérives.
Les quatre prérequis opérationnels
- Qualité de données : capteurs bien posés, étalonnés, et maintenus (un capteur, c’est aussi un équipement à maintenir).
- Référentiel équipements : nomenclature claire, arborescence machine, liens entre capteurs et organes (moteur, palier, réducteur).
- Process de réaction : qui valide l’alerte, qui intervient, sous quel délai, avec quel niveau de preuve.
- Implication du terrain : les techniciens doivent pouvoir challenger l’alerte, et voir rapidement des cas où elle a évité une panne.
Pièges fréquents : trop de capteurs, trop peu de retours
- Instrumenter “large” sans priorité : on crée un océan de signaux, mais aucune capacité à traiter les alertes.
- Ignorer les modes dégradés : une machine “bruyante” n’est pas forcément en panne, elle peut être en phase de démarrage ou sur une recette particulière.
- Ne pas documenter les interventions : sans retour précis (cause, pièce, symptôme), l’analyse de données s’appauvrit et les modèles stagnent.
La règle d’or : une alerte non suivie d’action (ou d’une décision documentée de ne pas agir) est une dette. Elle dégrade la confiance et brouille la lecture de la fiabilité.
Fiabilité et ROI : comment mesurer les gains, au-delà de la promesse technologique
Réduire un arrêt visible est spectaculaire, mais la valeur se joue aussi dans la stabilité : moins de micro-arrêts, moins de dérives qualité, une meilleure planification des interventions. Pour piloter, il faut quelques indicateurs simples, suivis sur la durée.
Les indicateurs qui parlent à la production et à la maintenance
- Taux d’arrêts non planifiés et durée cumulée d’arrêt machine sur les actifs ciblés.
- MTBF (temps moyen entre pannes) : doit progresser si la stratégie est efficace.
- MTTR (temps moyen de réparation) : baisse quand les interventions deviennent anticipées et mieux préparées.
- Taux de maintenance planifiée vs corrective : un bon signal de maturité.
- Qualité et rebuts liés aux dérives process : souvent sous-estimés dans le ROI.
Chiffrer le ROI de façon crédible
Le calcul le plus robuste croise trois éléments : coût horaire d’arrêt (ou marge perdue), probabilité d’occurrence, et réduction constatée après déploiement. On y ajoute des bénéfices indirects : moins d’urgences, moins d’heures supplémentaires, stocks de pièces mieux dimensionnés, et amélioration de la sécurité (moins d’interventions en situation dégradée).
Au final, la maintenance prédictive n’est pas un gadget de data science : c’est une discipline de pilotage. Quand les capteurs industriels sont posés au bon endroit, que l’analyse de données est contextualisée et que l’atelier transforme les alertes en actions, la promesse se matérialise : moins d’arrêts machine, une fiabilité qui progresse, et une usine qui reprend la main sur ses imprévus, plutôt que de les subir.